外文扫描论文逐页翻译
韩文、德文的扫描版论文,先识别文字再逐页翻译成对照文档。
- 适合谁
- 要读德文、韩文、日文等外文文献的研究生、科研人员和工程师,尤其是手上只有扫描件、复制不出文字的
- 要准备
- 扫描版论文或书的 PDF(图片也行),你领域里的术语习惯译法(可选)
- 用时
- 一篇二三十页的论文,识别和翻译约 20–30 分钟;你只看对照稿和术语表
- 用到
- 项目图片与扫描件识别云端电脑写 Word知识库技能
做出来是这样的
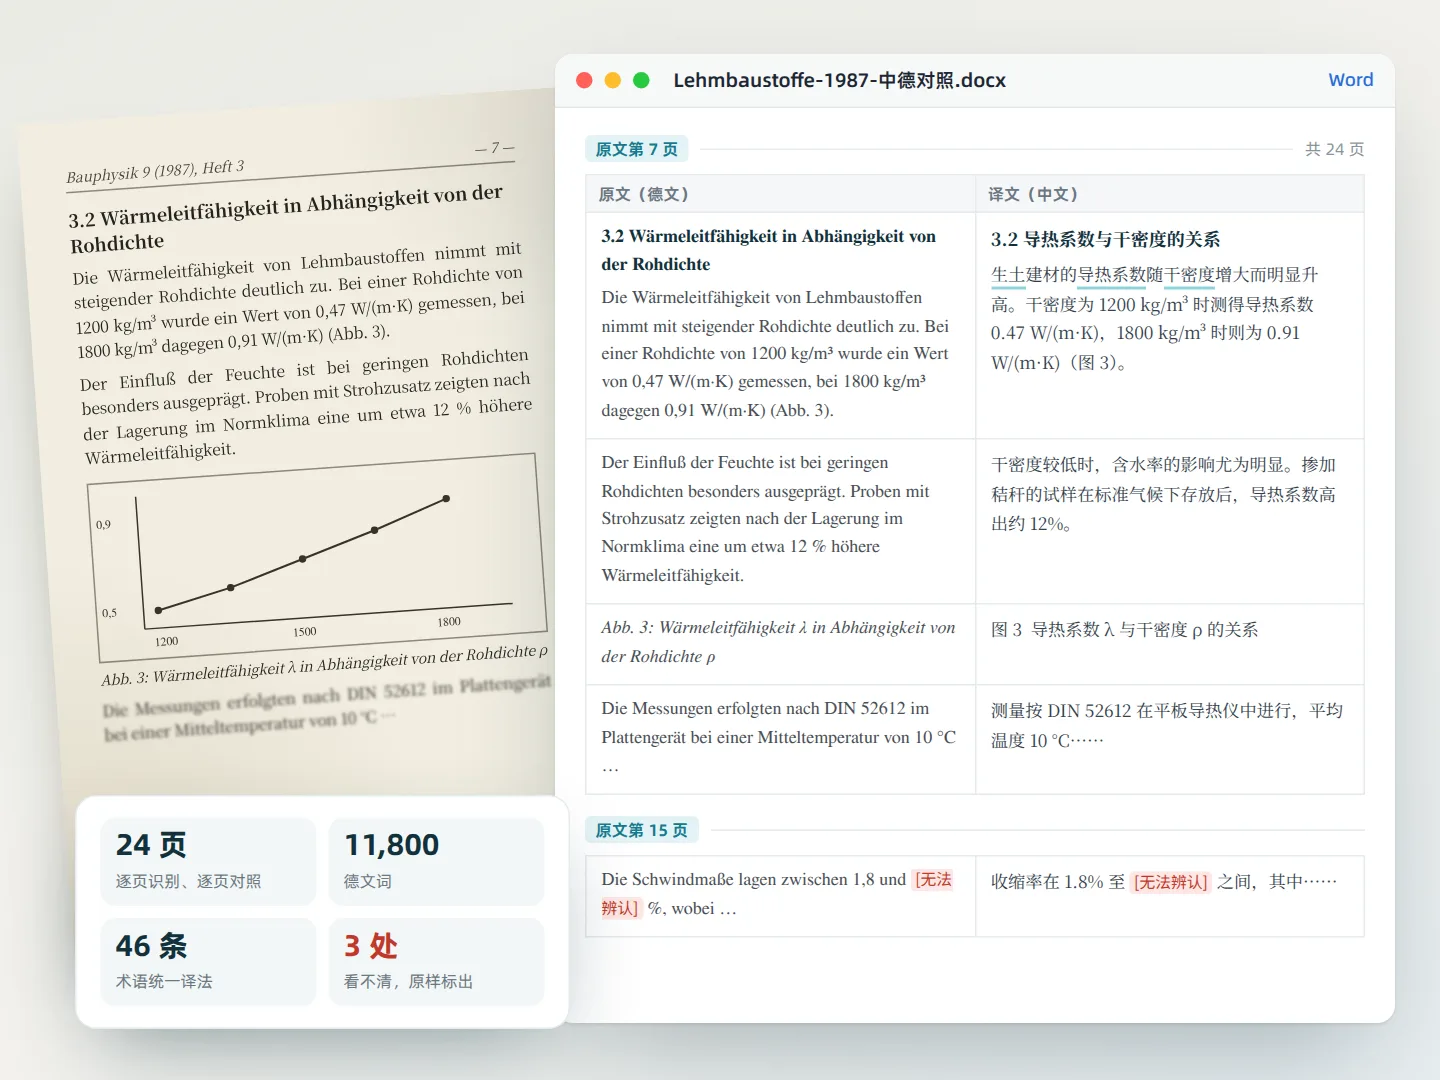
1扫描原文和逐页对照稿
2百言 AI 里的回复
24 页都识别并翻译完了,排成了逐页对照稿:
- 原文 识别 11,800 词,每段标原文页码,第 7 页对第 7 页
- 术语 46 条,如 Wärmeleitfähigkeit 统一译作“导热系数”
- 图表 图 9 张、表 6 张,标题和单位都已翻译
- 请确认 第 15 页有 3 处墨迹模糊,原样标“[无法辨认]”
它是怎么做出来的
材料交给百言 AI 后,在它自己的云端电脑上处理,你的电脑上什么都不用装。
一步步做
扫描件复制不出文字,普通翻译工具用不上。交给百言 AI 逐页识别再翻译,排成一页对一页的对照稿,查原文很方便。
-
01
创建项目“德文文献翻译”
在左侧边栏“项目”旁点 +,输入“德文文献翻译”,点“创建项目”。一篇论文开一个对话,原件、对照稿和术语表都在这里。
延伸同一个课题的文献都放在这个项目里,以后翻第二篇时,前一篇的术语译法还能接着用。
创建项目德文文献翻译内容永久保留,随时间扣除少量存储积分。
取消创建项目 -
02
上传扫描版论文
在项目里开启对话,点对话框左下角 +,选“添加文件”,传入扫描版 PDF。只有纸质原件的,逐页拍照,用“添加照片”上传。
延伸有中文摘要或你们组以前的译稿,也一起传上来,术语会按你们的习惯译。
德文文献翻译 工作空间PDFLehmbaustoffe-1987-scan.pdfEnter 发送,# 选择引用的文件自动 -
03
说清怎么翻、怎么排
写清楚:先识别原文再翻译、逐页对照还是只要中文、术语怎么处理、看不清的地方怎么标。有固定译法的术语直接列出来。
延伸只想先知道值不值得细读,可以说“先翻摘要和结论,再给我一页中文概要”。
德文文献翻译 工作空间先识别文字,再逐页翻成中文,左德右中对照。Lehm 译作“生土”,看不清的地方标出来,不要猜。好的。24 页都是扫描图片,我先逐页识别原文,第 1 页识别好后发你看一眼,没问题再继续。
-
04
百言 AI 逐页识别、逐段翻译
百言 AI 在云端电脑上把每一页摆正、识别成德文原文,保留段落和页码;再逐段翻译,同一个术语全文只用一种译法。识别不清的字原样标“[无法辨认]”,不凭上下文补。
延伸公式和数字照原文保留,图表里的坐标轴、图例也会翻译成中文。
正在云端电脑上处理- 逐页识别:24 页,德文 11,800 词
- 核对页眉页码、图表编号和公式编号
- 逐段翻译,统一术语 46 条
- 第 15 页 3 处模糊,标“[无法辨认]”
- 排版:左德右中,每页标原文页码
-
05
下载对照稿和术语表
回复里有三张成品卡片:中德对照的 Word、纯中文的 PDF 和术语表。点“下载”保存,读中文时看到存疑的句子,翻到同一页对照原文就行。
延伸接着问“第 4 节的实验方法能不能用在我们的样品上”,百言 AI 会结合译文回答,并告诉你出自第几页。
24 页都翻译好了。对照稿每页标原文页码,术语表 46 条,第 15 页 3 处识别不清已标出。
DOC 查看 下载PDF 查看 下载XLS 查看 下载 -
06
术语表放进知识库
点左侧“知识库”,新建“专业术语”,上传这次的术语表。以后翻同一领域的论文,在“知识库 · N”里勾选它,同一个词每篇都译得一样。
延伸也可以说“把这套识别加翻译的做法存成技能”,以后传扫描件说一句就开始。
知识库- XLS术语表-生土建材(德中).xlsx
- DOC课题组常用译法.docx
本次对话使用的知识库 专业术语 默认知识库
一键交给百言 AI
复制这段话,百言 AI 会一步步带你做完
包含上面的完整流程:要准备什么、怎么确认、交付什么、以后怎么一句话复用。你缺的信息,百言 AI 会一项项问你。点“在百言 AI 里打开”,这段话会直接填进对话框,看一遍再发送。
我有一份外文扫描版文献,想先识别文字再逐页翻译成中文。请按下面的流程带我完成。缺少的信息先问我,一次只问一个问题。

第一步:放进项目
先看当前对话是否属于项目。如果不属于,请告诉我:点对话框左下角的“+”,选“把对话放入项目”,新建项目,名字用课题或文献名。

第二步:收集原件
请我用“+”→“添加文件”上传扫描 PDF,纸质原件请我逐页拍照用“添加照片”上传。告诉我一共几页、是什么语言、有没有已有文字层。

第三步:确认要求
问我:要中外对照还是只要中文、术语有没有固定译法、图表要不要翻、交付什么格式。我有术语知识库的,请我在“知识库 · N”里勾选。

第四步:识别
逐页识别原文,保留段落、页码、图表编号和公式编号。先把第 1 页的识别结果给我看,我确认后再继续。识别不清的字标“[无法辨认]”,不要凭上下文补。

第五步:翻译和排版
逐段翻译,同一个术语全文只用一种译法,数字、单位和公式照原文。排成逐页对照稿,每页标原文页码;另出一份纯中文 PDF 和术语表(原文、译法、首次出现页码)。

第六步:交付和沉淀
回复里说明页数、词数、术语条数和无法辨认的位置。问我要不要把术语表存进知识库“专业术语”,以及要不要把这套做法存成技能。
做得更好的几个细节
- 扫描件越清楚越好,300 DPI 左右最合适;太糊的页可以重新扫一遍再传那几页。
- 先看第 1 页的识别结果,字母、变音符号和公式都对,再让它翻全文,返工最少。
- 韩文、日文的扫描件也是同样的做法,告诉它是什么语言就行。
- 术语的固定译法提前说清,比翻完再全篇替换省事得多。
- 译文用于发表或引用时,关键段落请对照原文再读一遍,尤其是数字和否定句。